
Le problème
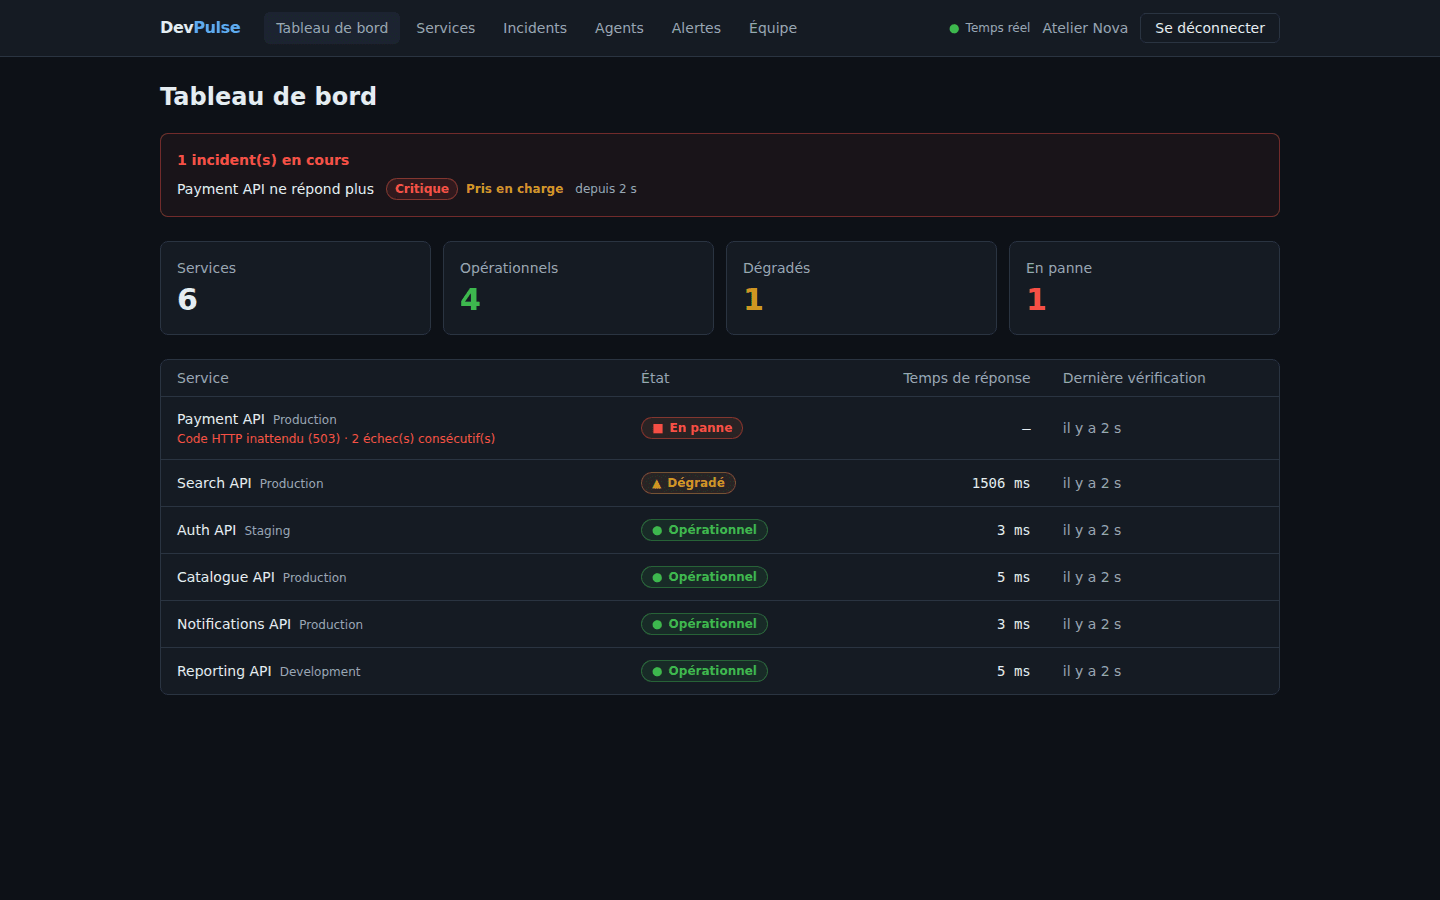
Une API tombe en pleine nuit. Il faut le savoir vite, savoir qui s'en occupe, prévenir les bonnes personnes, garder une trace, et ne réveiller personne pour un seul paquet perdu. DevPulse fait ce travail pour plusieurs organisations à la fois : chaque équipe enregistre ses API, DevPulse les sonde, ouvre un incident quand la panne est confirmée et le ferme quand le service revient.
Surveillance hybride
Sondes HTTP depuis la plateforme, et un agent Linux ou Windows pour les machines d'un réseau privé, avec sa propre clé révocable.
Incidents
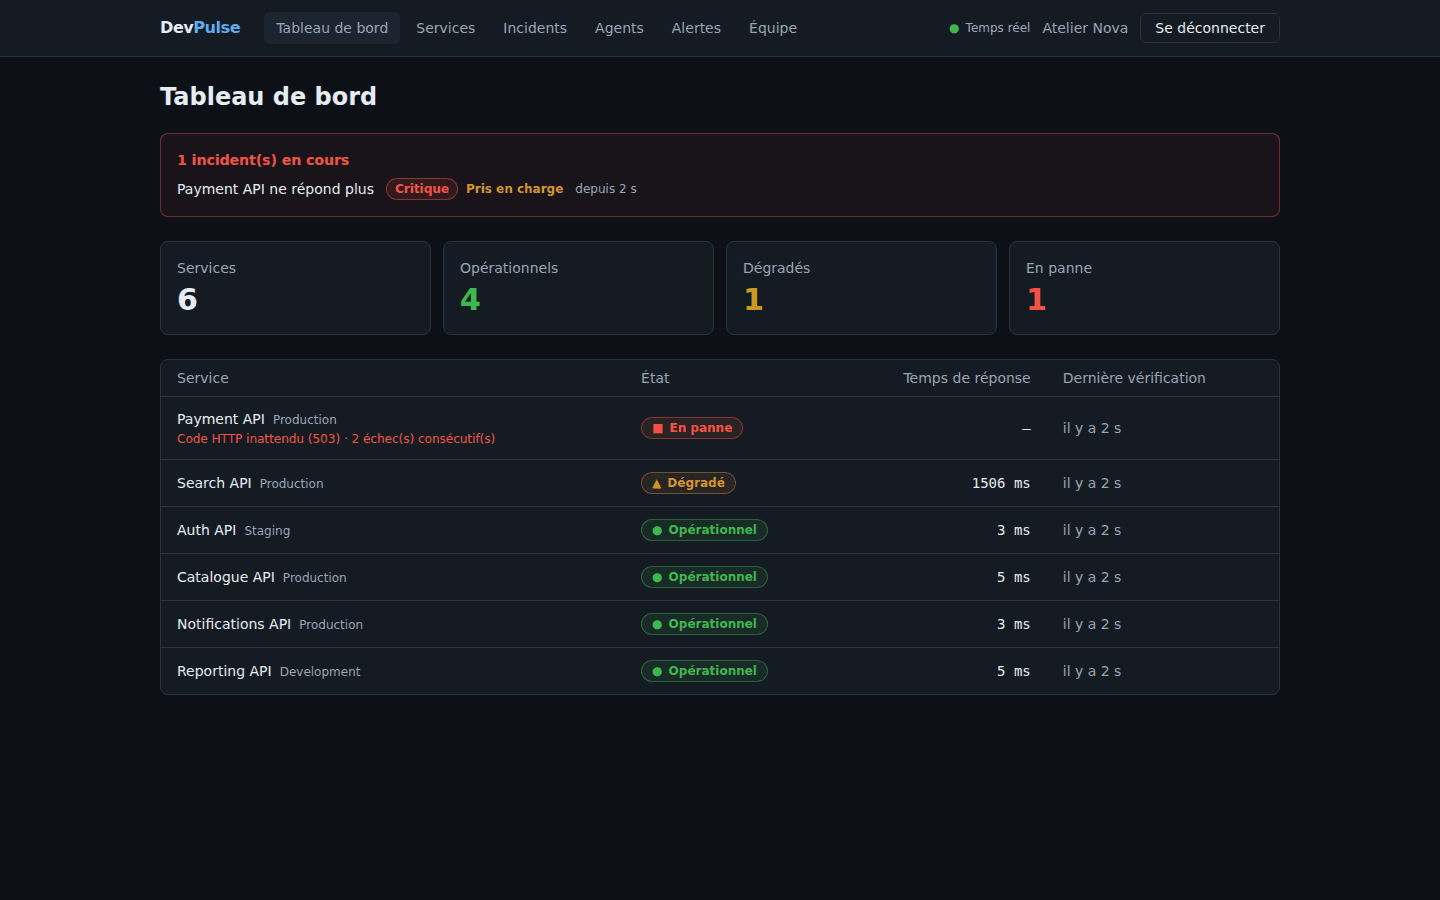
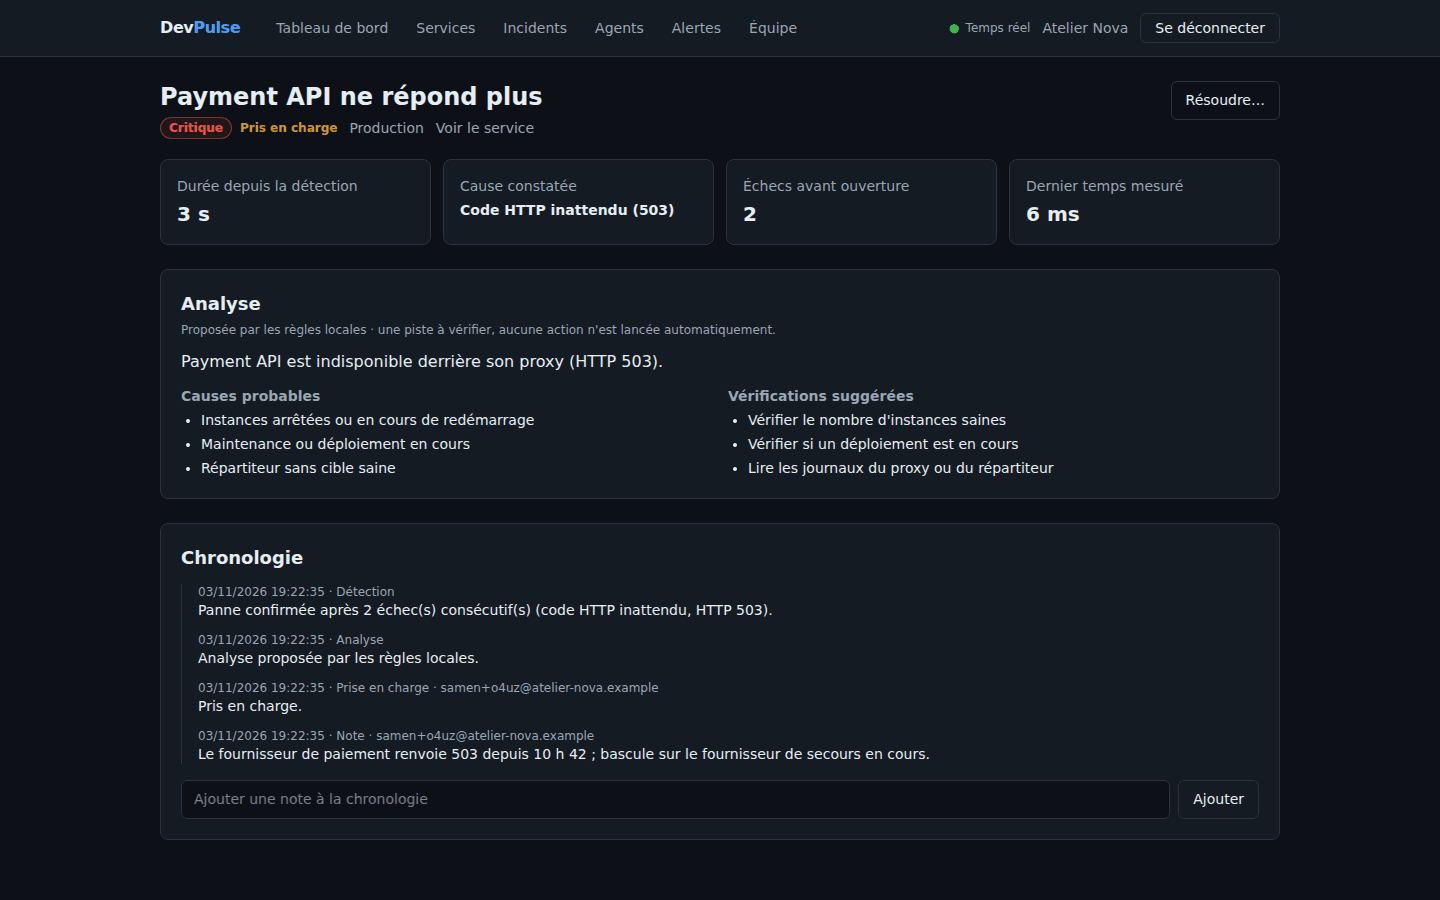
Ouverts au deuxième échec consécutif, pris en charge, annotés, fermés automatiquement au retour du service, avec chronologie et durée de résolution.
Alertes
Webhooks signés HMAC et Slack, avec règles par événement et par environnement, reprises avec délai croissant et historique des envois.
Analyse et temps réel
Proposition de causes et de vérifications (règles locales ou modèle compatible OpenAI), tableau de bord mis à jour en direct.
L'architecture
Sept composants .NET 10, chacun avec sa base PostgreSQL : Identity, Registry, Monitoring (API et worker de sondes), Incident, Alerting, un worker d'analyse et une passerelle YARP. Ils ne se partagent aucune table : ils s'échangent des événements par RabbitMQ. Le front est en Vue 3.
J'ai d'abord travaillé à partir d'un cahier des charges et d'un blueprint technique, que j'ai corrigés en les mettant en œuvre. Le blueprint liait par exemple une file à monitoring.service.* alors que les clés comptaient quatre segments : en AMQP, * remplace un seul mot, et cette file n'aurait jamais rien reçu, sans aucune erreur. Les décisions sont tracées dans 17 ADR.
Ne perdre aucun événement, n'en traiter aucun deux fois
C'est le cœur du projet. J'ai écrit la couche de messagerie directement sur RabbitMQ.Client, plutôt qu'avec MassTransit, dont la version 9 est payante.
- Outbox : l'événement est enregistré dans la même transaction que la modification qu'il annonce, puis publié avec confirmation du courtier. Si RabbitMQ est absent, il attend en base.
- Idempotence : chaque consommateur inscrit l'identifiant de l'événement dans la transaction de son traitement. Un doublon est acquitté sans effet.
- Reprises : une file d'attente à durée de vie réinjecte le message après un délai, puis une file morte le garde avec sa dernière erreur.
db.Set<ProcessedMessage>().Add(ProcessedMessage.Create(integrationEvent.EventId, registration.Queue, clock.GetUtcNow()));
try
{
    await db.SaveChangesAsync(ct);
}
catch (DbUpdateException e) when (DbErrors.IsUniqueViolation(e))
{
    return false; // déjà traité : acquitté sans effet
}

await route.Invoke(services, integrationEvent, ct);
await db.SaveChangesAsync(ct);
await transaction.CommitAsync(ct);
Mon premier test des doublons passait pour une mauvaise raison : lancé seul sur un courtier neuf, il publiait avant que la file existe, le message disparaissait et le test restait vert même sans déduplication. Je ne l'ai vu qu'en cassant volontairement la déduplication. Depuis, chaque protection importante est vérifiée de cette façon.
Sécurité
- Jetons RS256 : seul Identity possède la clé privée, un service compromis ne peut pas en fabriquer.
- Session : jeton d'accès en mémoire seulement, jeton de renouvellement en cookie
HttpOnlyremplacé à chaque usage. Un jeton rejoué révoque toute sa famille. - Isolation entre organisations : explicite dans chaque requête. Une ressource d'une autre organisation répond 404, y compris sur le flux temps réel, et des tests le vérifient service par service.
- SSRF : les URL surveillées et les webhooks sont choisis par l'utilisateur. Le contrôle qui fait foi porte sur l'adresse réellement contactée, au moment de la connexion, pour résister au DNS rebinding.
Qui surveille le surveillant ?
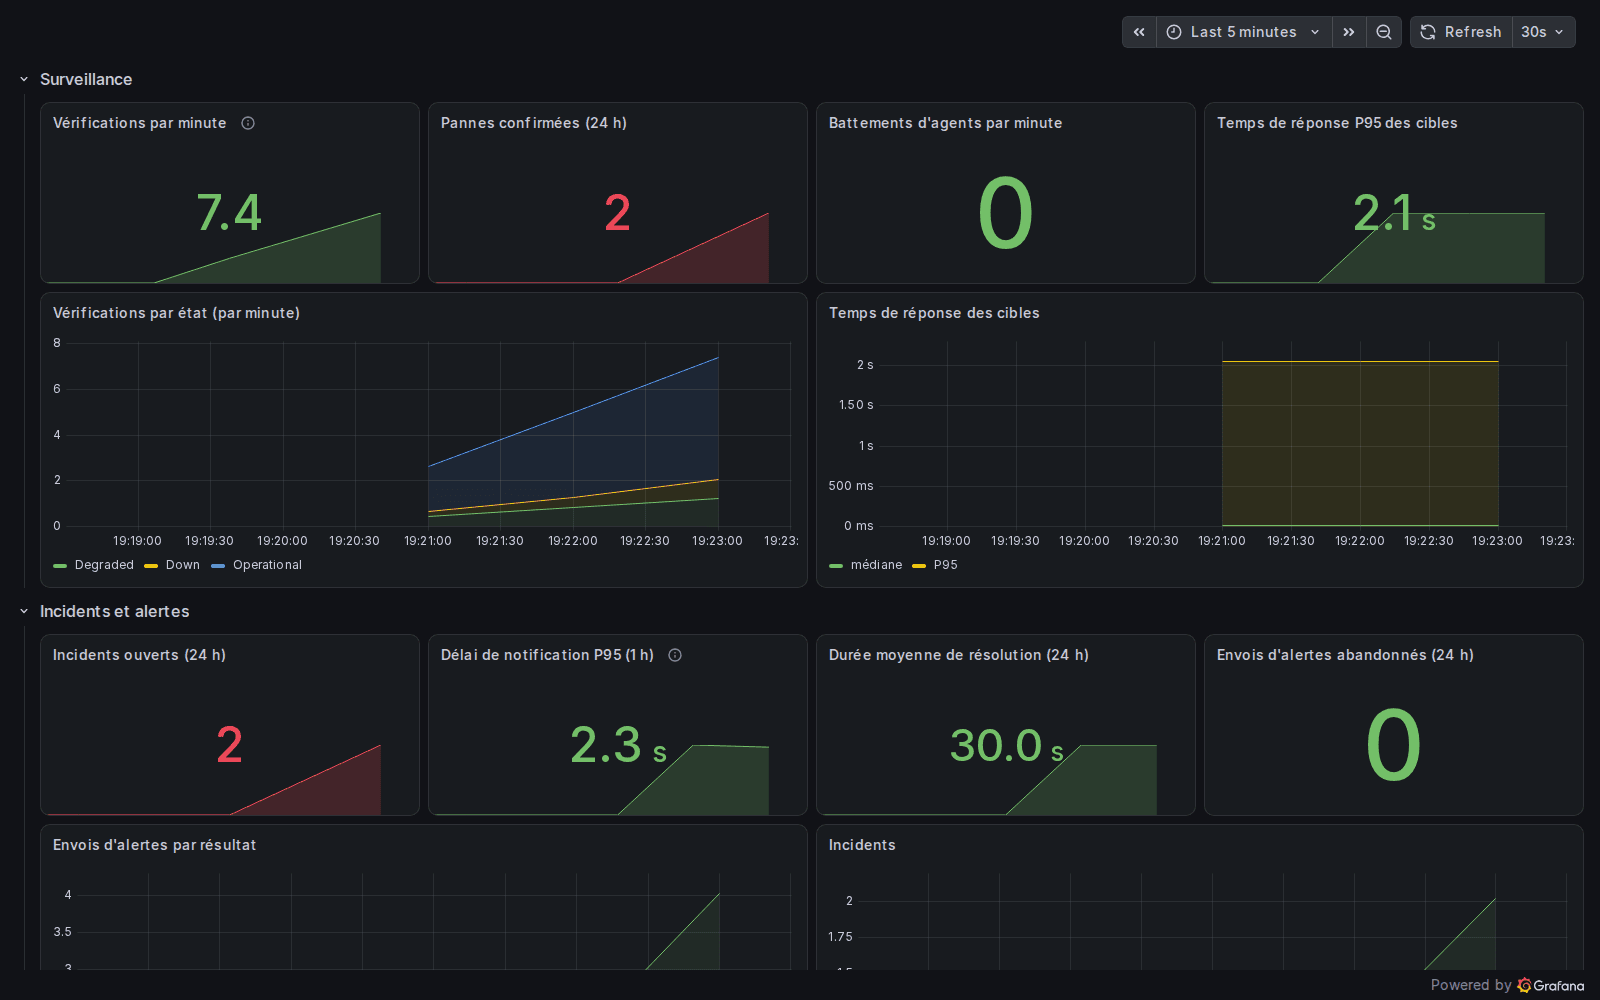
DevPulse se supervise lui-même avec OpenTelemetry : vérifications par minute, messages en file morte, âge de l'outbox, délai de notification, traces d'une panne de la sonde jusqu'au webhook. En local, tout arrive dans Grafana, avec un tableau de bord et cinq règles d'alerte versionnés. Sur Azure, la même télémétrie part vers Application Insights.
Ce qui est vérifié
257 tests .NET
Sur PostgreSQL et RabbitMQ réels (Testcontainers), plus 34 tests Vitest pour le front.
7 parcours navigateur
Playwright, joués en CI contre les images Docker de toute la plateforme : panne, incident, webhook, invitation, isolation.
Notification en 26 à 73 ms
Entre la panne confirmée et la réception du webhook signé, sur quatre mesures (poste et CI). L'objectif était 10 s.
Charge
k6 en CI : environ 46 000 requêtes en 30 s pour 20 utilisateurs, aucune erreur, 95 % sous 21 ms.
La CI construit les images, démarre la plateforme complète, rejoue les parcours, mesure la charge, contrôle que métriques et traces arrivent dans Grafana, et valide le Terraform AWS (ECS Fargate) et Azure (Container Apps).
Pas encore déployé dans le cloud : les deux Terraform sont validés et chiffrés, mais pas appliqués. Le prochain pas est un déploiement de démonstration sur Azure Container Apps. Projet réalisé avec l'aide d'un assistant IA de programmation ; les choix, les mesures et leurs limites sont documentés dans le dépôt.
Ce que j'en retiens
Un système distribué se juge à ce qu'il fait quand quelque chose rate : un courtier absent, un message livré deux fois, une reprise arrivée avant la panne qu'elle termine. Écrire ces garanties moi-même, puis casser chacune volontairement pour voir le test échouer, m'a appris plus que n'importe quel framework qui les aurait cachées. L'autre leçon : un chiffre n'a de valeur qu'avec ses conditions. Chaque mesure de ce projet dit où et comment elle a été prise.