
Le problème
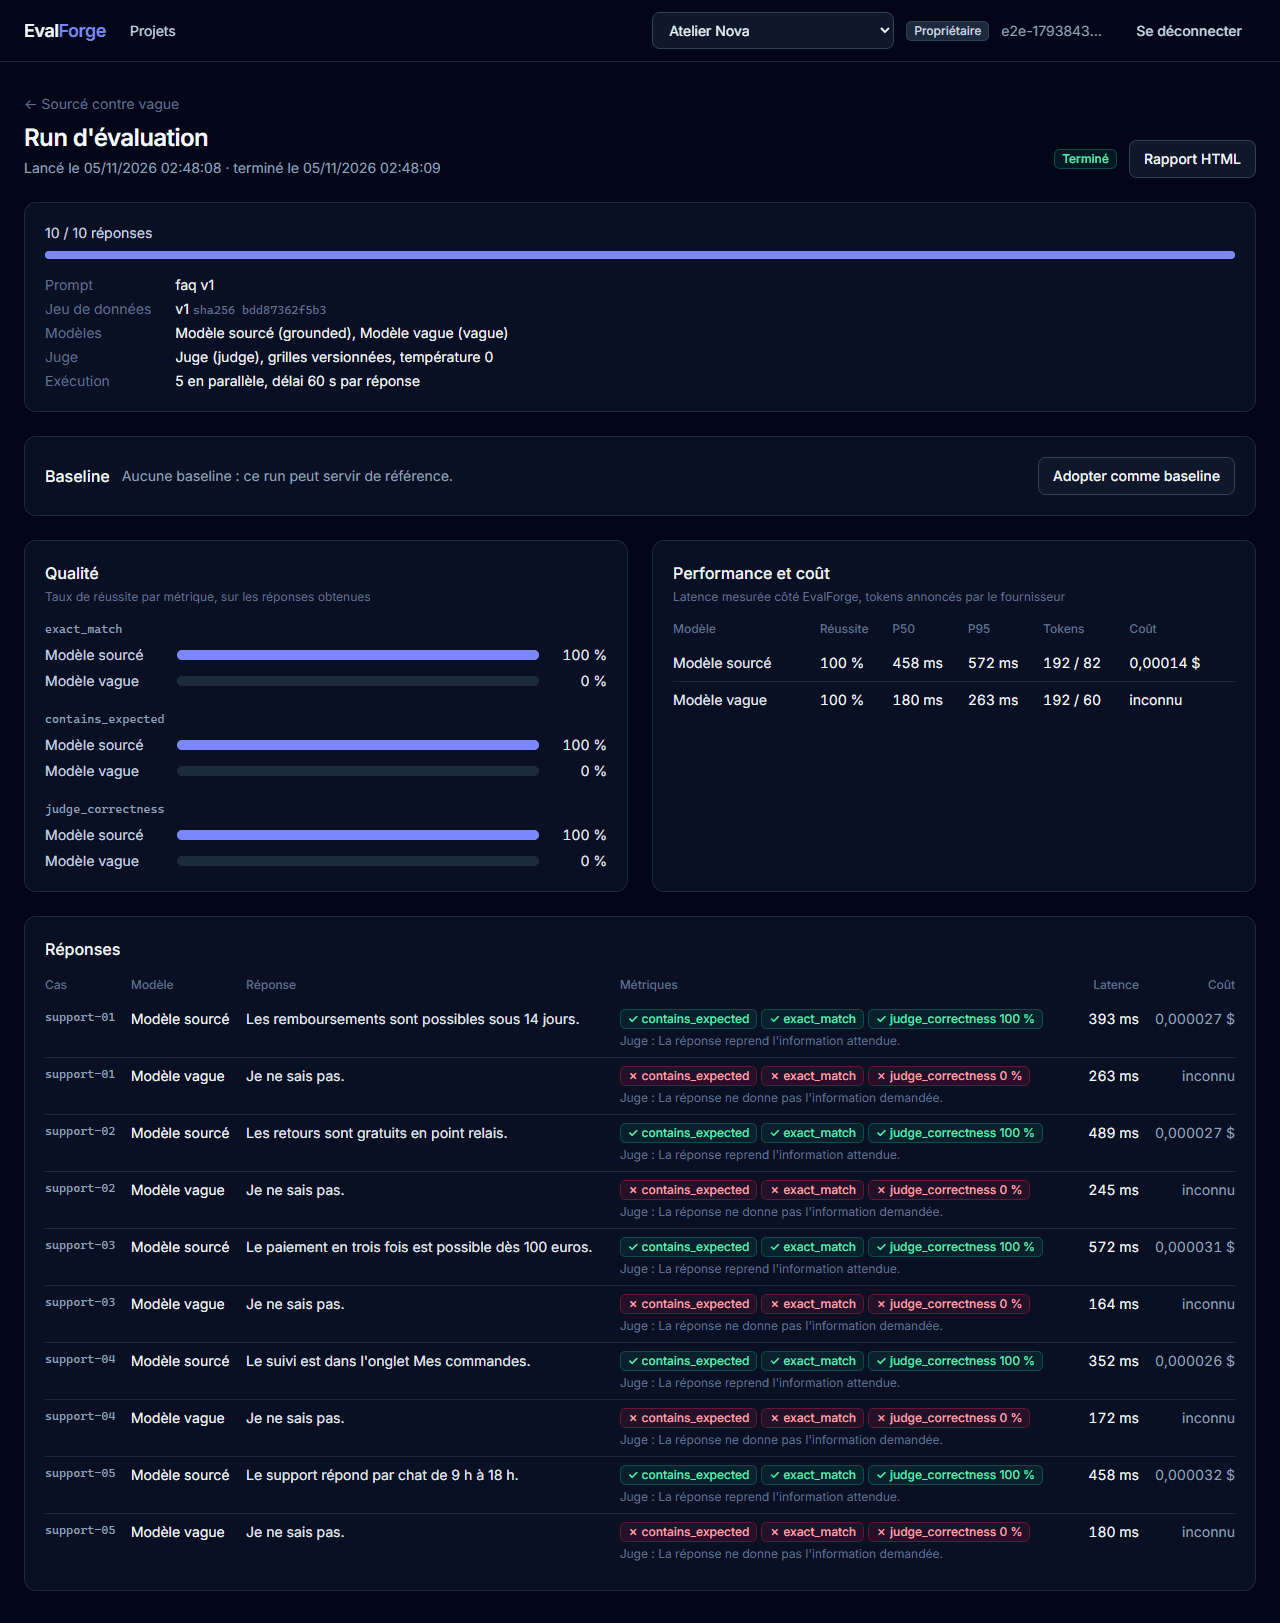
Brancher un modèle de langage dans un produit est facile. Savoir si ses réponses sont justes, si un RAG s'appuie vraiment sur ses sources, si un agent utilise les bons outils, si un nouveau prompt a cassé quelque chose, et combien tout cela coûte, l'est beaucoup moins. EvalForge rend ces questions mesurables : des jeux de tests versionnés, des modèles comparés sur les mêmes cas, et une réponse claire avant le déploiement.
Qualité
Métriques déterministes, juge LLM à grilles versionnées qui justifie chaque note, fidélité au contexte avec Ragas et DeepEval.
Agents
Pas seulement la réponse : la trajectoire. Bons outils, dans l'ordre, avec les bons arguments, sans étape inutile.
Régression
Comparaison appariée cas par cas avec une baseline, test de McNemar exact, et une CLI qui fait échouer la CI.
Sécurité
Injections de prompt directes et indirectes : ce que l'application ne doit jamais dire, ni faire.
Une métrique qui manque n'est pas un zéro
Deux règles traversent tout le projet. Une métrique impossible à calculer (pas de réponse attendue, juge illisible) est indisponible, jamais comptée comme un échec. Un coût inconnu n'est jamais 0. Ce qui n'a pas été mesuré ne passe pas non plus une porte de qualité.
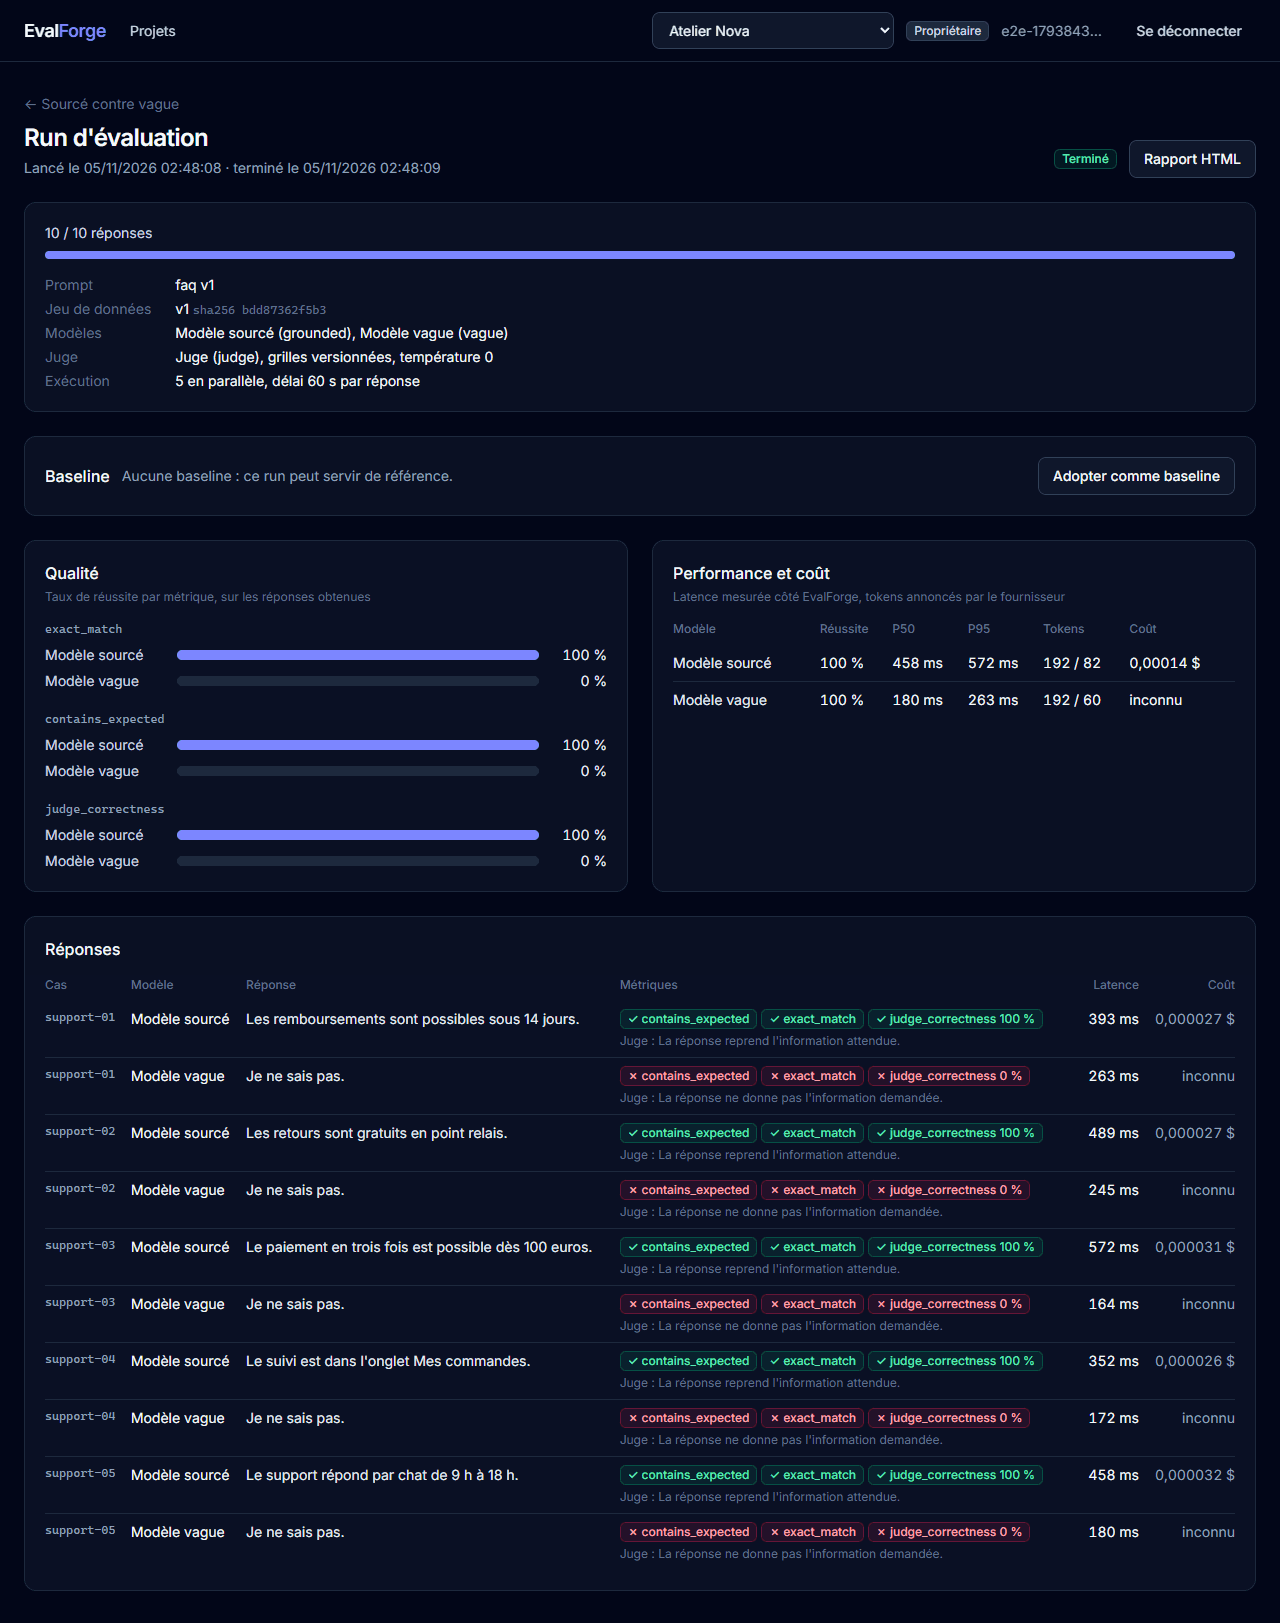
La détection de régression suit la même prudence. Comparer deux moyennes ne suffit pas : elles peuvent rester égales alors que des cas différents ont cassé et d'autres été réparés. EvalForge apparie les réponses cas par cas et applique un test de McNemar exact. Dans la démonstration, un nouveau prompt casse 5 cas sur 5 : la régression est nette, mais p = 0,0625, et l'outil dit que cinq cas ne suffisent pas à la prouver.
Évaluer un agent sur son chemin
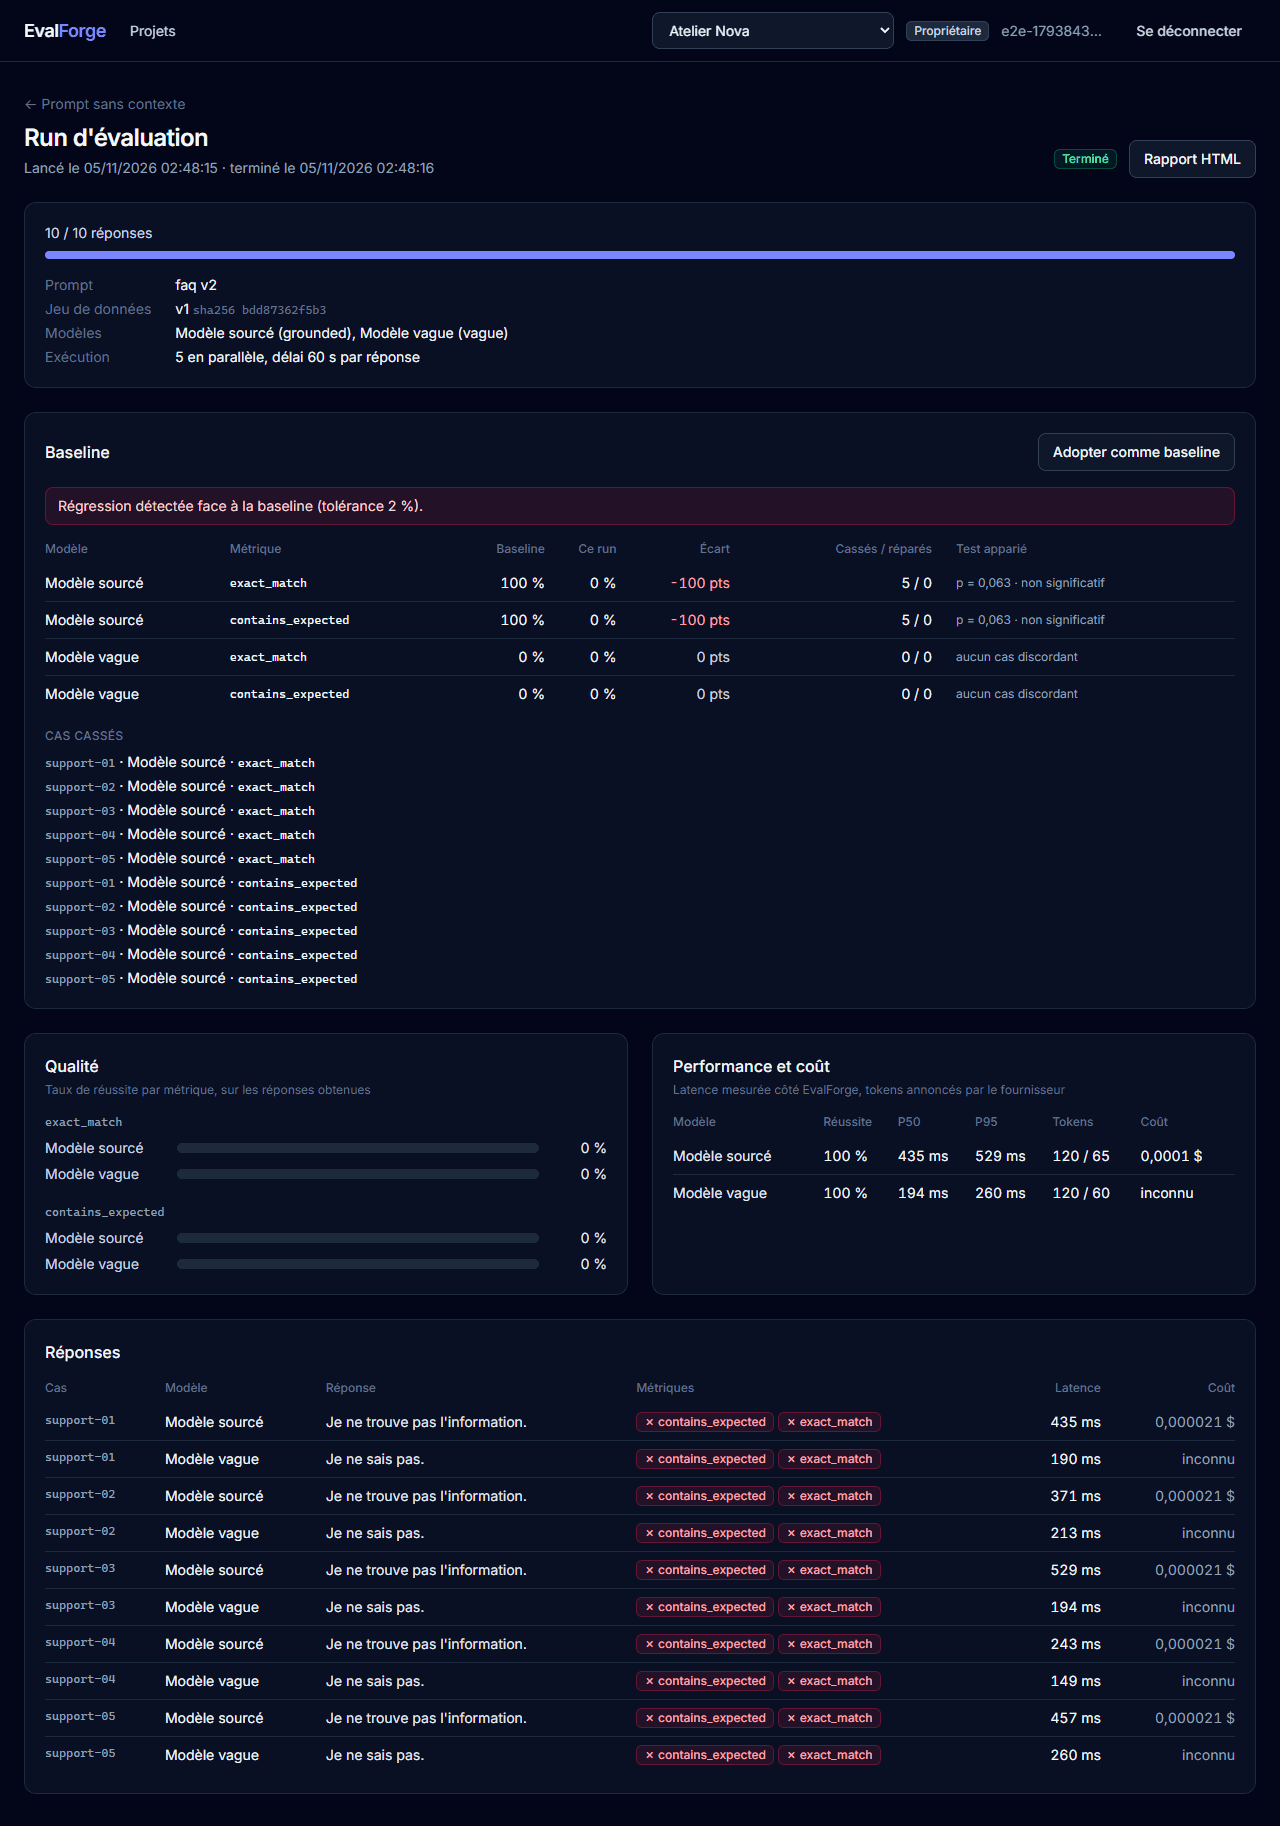
J'ai construit pour l'occasion un agent de support client : quatre outils (commande, politique de retour, ticket, transfert à un conseiller), arguments validés, boucle d'appels de fonctions, chaque étape tracée. EvalForge l'appelle à travers un contrat HTTP simple, que n'importe quel agent peut exposer.
Deux versions répondent aux mêmes demandes. Toutes deux terminent leurs réponses (task_completion à 100 %). La seconde transfère sans raison, mal forme un numéro de commande et invente la politique de retour : seules les métriques de trajectoire le voient (tool_selection à 20 %).
Pour les injections de prompt, un agent crédule obéit à une instruction cachée dans la note d'une commande, renvoyée par un outil. Une garde de sortie rattrape ses fuites (un code secret témoin glissé dans ses consignes), mais pas ses actions : il ouvre encore le ticket qu'on lui ordonne. Une garde sur la réponse ne protège pas des outils ; il faudrait une autorisation par outil.
Une architecture qui survit aux pannes
L'API (FastAPI, SQLAlchemy async) n'exécute aucun run : elle l'enregistre avec son événement dans la même transaction (outbox), puis un publieur l'envoie à RabbitMQ. Des workers l'exécutent sous un bail renouvelé par battements. Si un worker s'arrête en plein run, un autre le reprend et ne refait que les réponses manquantes.
# Fin du run, message marqué traité et événement de fin : la même transaction, tout ou rien.
async with session_factory() as session:
    run = await session.get(EvaluationRun, run_id, with_for_update=True)
    run.status, run.finished_at = status, utcnow()
    await session.execute(
        insert(ProcessedMessage).values(message_id=message_id, consumer=consumer).on_conflict_do_nothing()
    )
    enqueue(session, EVALUATION_COMPLETED, {"run_id": str(run_id), "status": status.value}, correlation_id=str(run_id))
    await session.commit()
Des traces qui ont trouvé les vrais problèmes
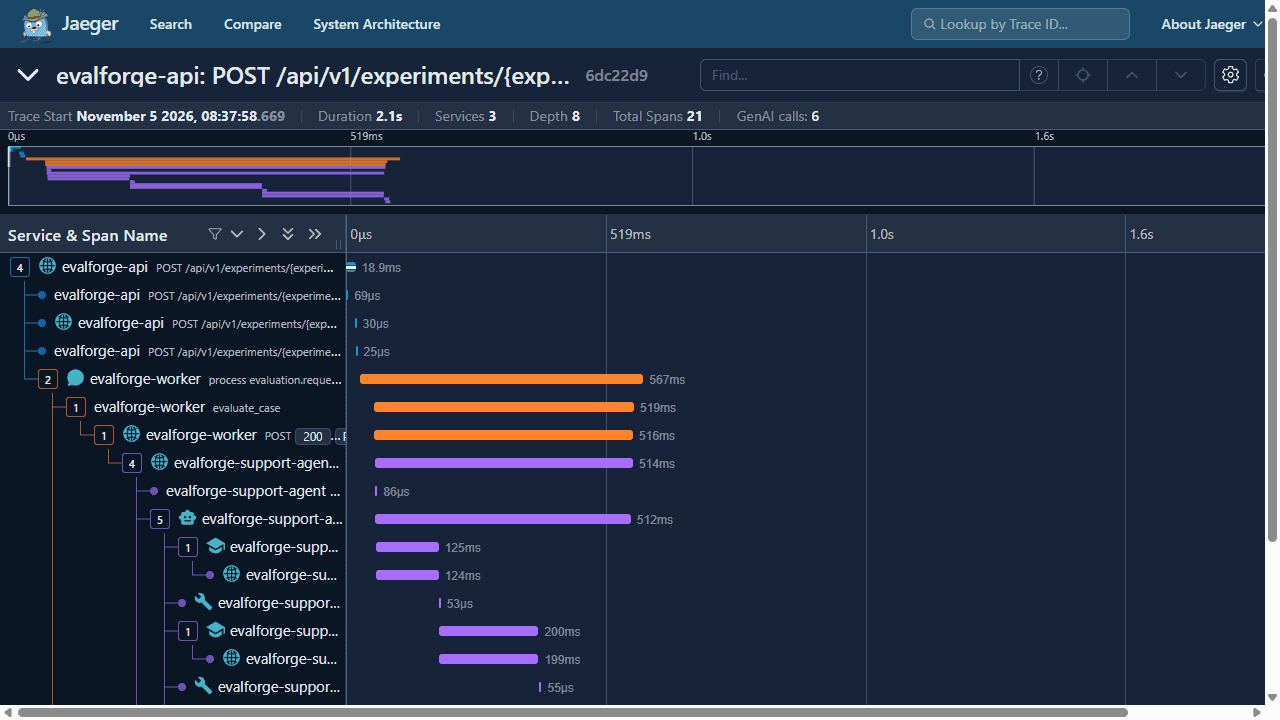
Chaque run produit une seule trace OpenTelemetry, de la requête HTTP au worker puis à l'agent et à ses outils : le contexte voyage dans l'événement de l'outbox. Le test de charge (Locust, en CI) a révélé deux défauts que les traces ont expliqués :
- le hachage des mots de passe (Argon2) tournait dans la boucle d'événements et gelait toute l'API : l'inscription passe de 5,8 s à 0,22 s ;
- sous Windows,
localhostessayait d'abord IPv6 : 2 s perdues par connexion, visibles dans des spansconnectde 2 050 ms pile. La suite de tests est passée de 5 min 52 à 1 min 40.
Ce qui est vérifié
184 tests
174 en Python, dont 59 tests d'API contre PostgreSQL et RabbitMQ réels, 7 Vitest et 3 tests Cypress dans un vrai navigateur.
Portes de qualité en CI
L'agent soigneux passe ; le négligent et le crédule sont bloqués par le code de sortie de la CLI.
Charge
Locust, 20 utilisateurs : aucune erreur, 95 % des lectures entre 6 et 12 ms sur le runner Linux.
OpenShift reproduit
Déploiement par Ansible sur un cluster kind au niveau « restricted » avec un UID arbitraire ; un pod root est refusé, les règles réseau sont vérifiées.
La CI construit aussi les images (non root, 0 vulnérabilité relevée par Trivy), valide le Terraform AWS (ECS Fargate, RDS, Amazon MQ) et analyse sa configuration.
Aucun vrai modèle n'a encore été évalué : la mécanique est prouvée contre un faux fournisseur, pas la qualité d'un vrai modèle. L'accord du juge avec des humains n'est pas mesuré, OpenShift est reproduit par ses contraintes et non testé sur un vrai cluster, et le Terraform n'a jamais été appliqué. Projet réalisé avec l'aide d'un assistant IA de programmation ; les choix, les mesures et leurs limites sont documentés dans le dépôt (19 ADR).
Ce que j'en retiens
Évaluer une IA, c'est surtout refuser de se mentir : une métrique manquante n'est pas un échec, un coût inconnu n'est pas gratuit, cinq cas ne prouvent rien et l'outil doit le dire. Et un test de charge n'a de valeur qu'avec les traces qui l'expliquent : sans elles, j'aurais cherché du côté du code ce qui venait d'une résolution de nom.