
Le contexte
Chaque conversation avec une IA repartait de zéro. La preuve la plus concrète, ce sont mes candidatures de stage : à chaque offre, je réadaptais mon CV, et l'IA qui m'aidait ne me connaissait pas, ou pas à jour. Je lui redonnais mon contexte, mes expériences, mes projets, ce qui collait à l'offre. Quand j'oubliais un détail, je repartais le chercher dans une autre IA. Mon profil était dispersé entre plusieurs IA, chacune avec sa version de moi. Je voulais que ma base de connaissances soit accessible par n'importe quelle IA (ChatGPT, Claude, Cursor, opencode), pas enfermée dans un seul outil.
Ce que j'ai construit
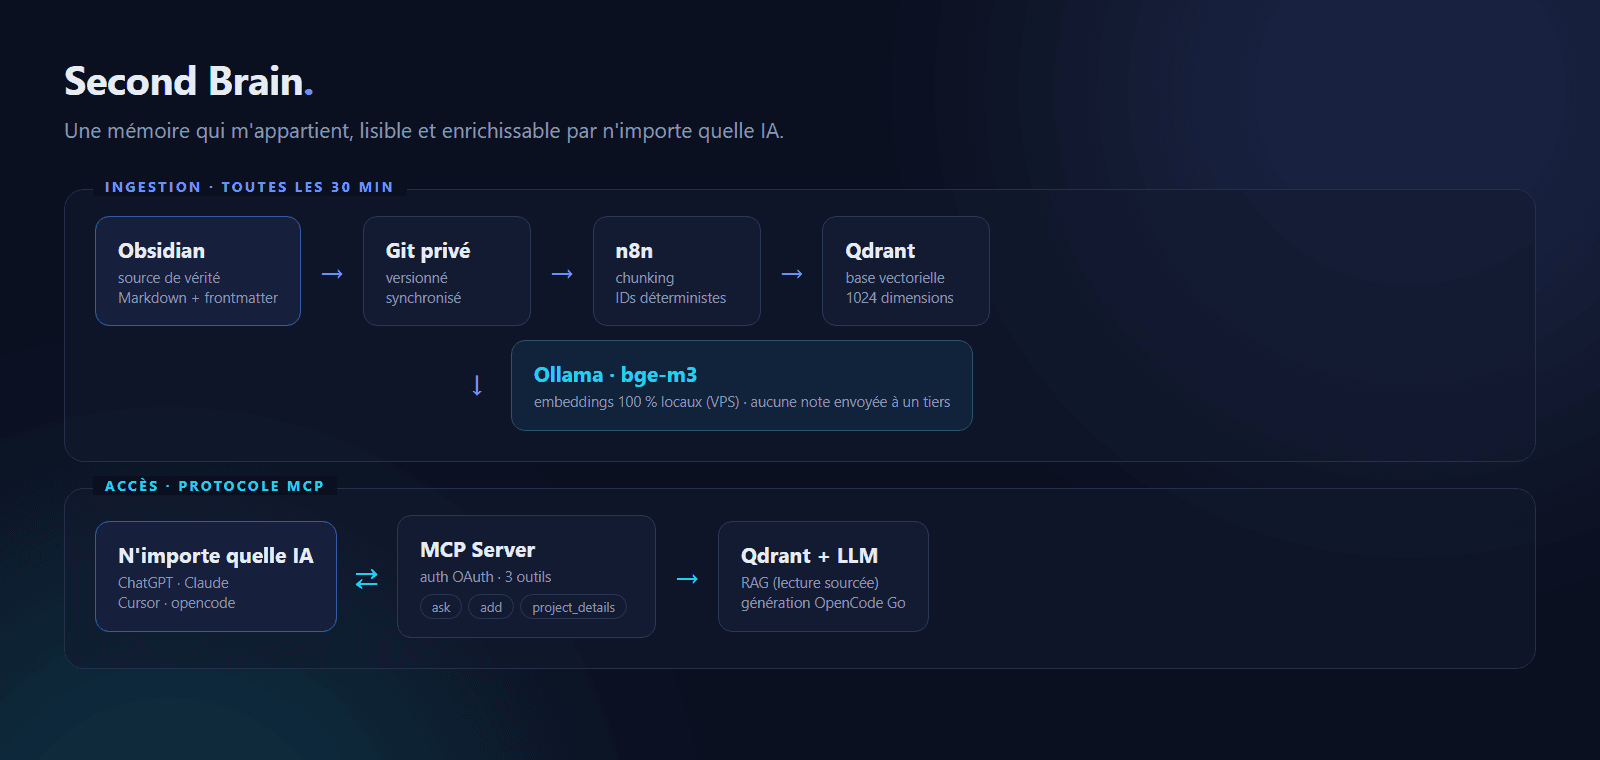
Un « second cerveau » auto-hébergé : un vault Obsidian comme source de vérité, versionné sur un repo GitHub privé, indexé par un pipeline n8n dans Qdrant (vector store), embarqué en local avec Ollama bge-m3, et généré avec DeepSeek V4 Flash Vision (via la passerelle OpenCode Go). Le tout est exposé à n'importe quelle IA via un serveur MCP dédié, authentifié en OAuth.
Trois outils MCP :
second_brain_ask
RAG sur toute ma base : n'importe quelle IA pose une question et reçoit une réponse sourcée (projets, stack, CV, leçons apprises).
second_brain_add
N'importe quelle IA peut écrire des notes. Chaque note est classée automatiquement (type, tags, dossier), vérifiée contre les doublons, et mise en quarantaine jusqu'à validation.
second_brain_project_details
L'IA part chercher la vraie implémentation d'une fonctionnalité dans le code réel (GitHub), à la demande. Branché sur GitHub aujourd'hui, sur d'autres outils demain (GitLab, tickets, doc interne), sans gonfler le vault.
Ingestion différentielle (toutes les 30 min)
Repo privé, chunking à IDs déterministes, seuls les chunks nouveaux ou modifiés sont embarqués (~2 s en régime stable). Idempotente et sans perte.
Housekeeping (hebdomadaire)
Un rapport signale les paires de notes redondantes (similarité sémantique), écrit en quarantaine pour relecture.
Impact
Une base, toutes les IA
Une seule URL MCP (/mcp/second-brain-kb, auth OAuth) permet à ChatGPT, Claude, Cursor ou opencode de LIRE et d'ÉCRIRE dans ma base, avec citations des sources.
Confidentialité par conception
Les embeddings tournent 100 % en local (Ollama) sur mon VPS, aucun tiers n'indexe mes notes. Zéro coût API supplémentaire.
Validation humaine
Rien de ce qu'une IA écrit n'entre dans la base interrogeable sans validation (status: pending), un garde-fou contre l'injection de prompt.
Ingestion robuste
IDs déterministes, aucun doublon, même en exécutions concurrentes ; nettoyage horodaté, aucune perte. ~2 s en régime stable.
Contrôles qualité
Écritures dupliquées refusées à ≥ 75 % de similarité, notes auto-classées, rapport de redondances hebdomadaire.
À quoi ça me sert (au-delà des candidatures)
Le CV a été le déclencheur, mais la même base sert à bien d'autres choses : préparer un entretien (« résume le projet X et mes choix techniques »), retrouver une décision d'architecture dans mes notes, faire plonger l'IA dans la source d'un projet, ou alimenter mes articles. Chaque fois, c'est du temps gagné à ne pas réexpliquer ni refouiller.
Et surtout : l'IA connaît ma manière de développer (structure, nommage, patterns, bonnes pratiques). Sur un nouveau projet, elle applique ce que j'ai déjà bien fait ailleurs, au lieu de produire du code générique.
Ce que cette expérience m'a appris
Livrer un serveur MCP en production m'a apporté plusieurs leçons dures : les nœuds de modèle OpenAI n'exposent pas les headers custom (la passerelle OpenCode Go exige x-opencode-session), appeler l'API directement en HTTP ; splitInBatches s'arrête sur un item vide, préférer les pipelines linéaires ; les écritures IA non contrôlées sont une vraie menace, le pattern de quarantaine par statut est le garde-fou le plus simple et le plus efficace ; et une ré-indexation n'est pas idempotente par défaut, des IDs déterministes (hash du contenu) rendent l'ingestion sans doublon, différentielle et quasi instantanée.